AI Agent Benchmarks 入门:14 个代表性评测,分别在测什么?
AI Agent Benchmarks 入门:14 个代表性评测,分别在测什么?
阅读 AI 模型的发布介绍,经常会遇到一串陌生名字:DeepSWE、Terminal-Bench、OSWorld、GraphWalks……它们都叫 benchmark,也都可能用百分比展示成绩,但给 AI 安排的“考试”差别很大:有的要求开发一个应用,有的要求操作办公软件,有的要求读懂专业图表。
Benchmark,即基准评测,可以理解为一套相对固定的任务与评分规则。用于评估 AI Agent 时,它通常还需要一个可操作的环境,让 AI 使用工具、观察结果、继续执行,最后检查任务完成得怎么样。
认识这些评测,可以先抓住三个问题:它让 AI 做什么?任务有什么特别之处?最后评价哪些能力? 本文按工作场景介绍 14 个代表性评测与指数,其中既有完整工作流程的测试,也有支撑 Agent 的推理和感知能力测试。
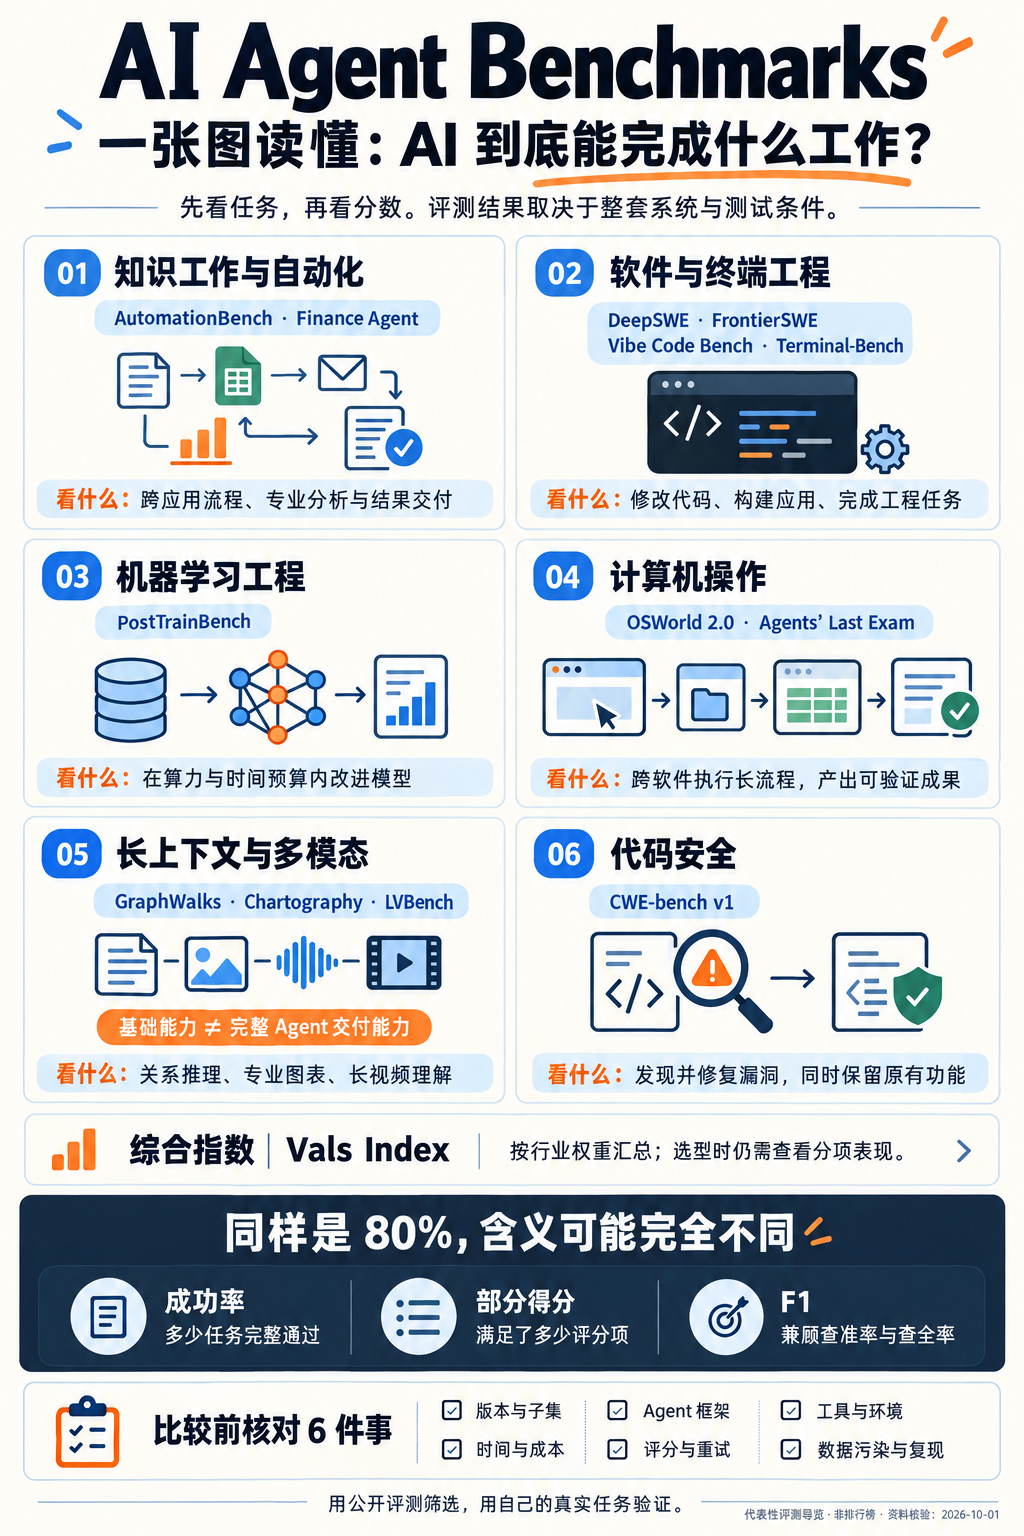
先用一张表建立整体印象:
| 评测或指数 | 主要测试对象 | 最值得记住的特点 |
|---|---|---|
| AutomationBench | 跨应用业务自动化 | 通过 API 串起多个业务系统 |
| Finance Agent | 金融研究与分析 | 找对来源、算对数字、遵循专业口径 |
| Vals Index | 多领域综合表现 | 将行业任务成绩加权汇总 |
| DeepSWE | 长流程软件工程 | 原创任务与专门编写的功能验证器 |
| FrontierSWE | 高难度工程与研究 | 在较长时间预算内推进复杂技术工作 |
| Vibe Code Bench | 从需求构建 Web 应用 | 用浏览器流程检验应用功能 |
| Terminal-Bench | 命令行环境中的工作 | 在真实终端里执行并完成任务 |
| PostTrainBench | 语言模型后训练 | 在限定算力和时间内改进目标模型 |
| OSWorld 2.0 | 长流程计算机操作 | 处理跨软件、动态环境与隐藏状态 |
| Agents' Last Exam | 专业工作的完整交付 | 在操作系统沙盒中检查最终产物 |
| GraphWalks | 长上下文中的图推理 | 沿关系进行多步计算,评价节点集合 |
| Chartography | 专业图表理解 | 识别复杂视觉信息与领域图示规则 |
| LVBench | 长视频理解 | 跨较长时间跨度提取和关联信息 |
| CWE-bench v1 | 代码安全审计与修复 | 阻断漏洞利用,同时保留正常功能 |
AutomationBench:AI 能不能把业务流程跑通?
AutomationBench 是一项跨应用工作流评测,由 Zapier 团队提出,任务覆盖销售、市场、运营、客服、财务和人力资源等业务领域。Agent 需要通过 REST API 与应用交互,把一个目标拆成一连串操作。
它的特点是关注多个系统之间的衔接。用一个示意场景理解:根据客户记录核对订单,再把处理结果更新到另一个系统。Agent 要知道去哪里取数据、下一步调用哪个接口,以及如何把前一步的结果变成后一步的输入。
重点测试:流程规划、工具选择、参数填写、跨系统信息传递,以及多步执行的正确性。 这类评测主要通过 API 完成操作,不能直接用来代表鼠标点击、界面识别等图形界面能力。AutomationBench 论文
Finance Agent:AI 能不能完成金融分析师的资料研究?
Finance Agent 由 Vals AI 发布,围绕金融分析师的核心任务展开。以 v2 为例,问题涉及上市公司披露材料、盈利分析、可比公司分析和财务建模等,需要借助搜索、文档提取和计算工具完成回答。
它的特点是把信息检索与专业计算结合起来。找到一个数字还不够,Agent 还需要确认年份、定义和计算口径,再将多个中间结果连接起来。官方评分包含关键检查项:如果关键事实或数字出错,即使其他部分写得完整,该题也可能得零分;同时报告部分得分与全部通过两种指标。
重点测试:财务资料检索、跨文档整合、数值精度、多步计算和金融概念的正确应用。 它帮助评价研究与分析任务的完成质量,不能据此推断投资收益。Finance Agent 官方方法说明
Vals Index:多个专业领域的综合成绩单。
Vals Index 是 Vals AI 发布的综合指数。它汇总金融、编程、法律、税务等领域的 Agent 任务成绩,并按照相关行业在美国 GDP 中的份额进行加权。
它的特点在于汇总方式:单项评测聚焦一种任务,指数则尝试形成跨领域的整体视角。因此,它没有一种统一的“典型考题”,具体任务和评分来自组成它的各个评测。
重点反映:多个专业领域上的综合表现。 阅读它时,可以先看整体,再看分项:总分接近的两个系统,可能一个更擅长金融,另一个更擅长编程。指数权重也不一定等于某个读者的工作需求。Vals AI 官方目录
DeepSWE:AI 能不能完成真实代码库中的复杂工程任务?
DeepSWE 面向 coding agent,也就是能够阅读、修改并运行代码的智能体。论文介绍的任务是在活跃开源代码库上原创编写的长流程工程任务,覆盖多种编程语言。
它有两个鲜明特点。第一,任务从头编写,减少直接记住公开历史补丁的机会。第二,为任务专门编写验证器,按要求的功能验收,允许采用不同实现方式。这样,评价更聚焦于是否实现了需求。
重点测试:代码库理解、工程需求落实、跨文件修改和持续调试能力。 可以把它理解为给 Agent 分配一项需要真正进入项目内部才能完成的开发工作。原创任务能降低某些污染风险,但并不意味着评测从此不存在任何泄漏或投机可能。DeepSWE 论文
FrontierSWE:AI 能不能长时间推进高难度技术挑战?
FrontierSWE 聚焦高难度、超长流程的软件工程与研究任务,涵盖系统实现、性能优化、科学计算和 AI 研究等方向。官方任务中可以看到推理系统优化、编译器相关工作、天气预测模型等技术挑战。
它的特点是任务跨度大,允许 Agent 长时间尝试。v2 的方法给每次运行 20 小时预算,并让 Agent 感知剩余时间。面对这样的任务,Agent 需要不断选择方向、进行实验、观察反馈和调整方案。
重点测试:长期规划、复杂实现、实验迭代、性能改进与时间预算管理。 它更接近长时间技术项目的测试,成绩应结合具体任务的评分规则理解。FrontierSWE 官方任务与方法
Vibe Code Bench:给 AI 一份产品需求,它能不能做出可用应用?
Vibe Code Bench 评估从自然语言规格出发、完整构建 Web 应用的能力。任务让 Agent 从需求走向可以部署和操作的产品,再通过浏览器工作流进行评价。
它的特点是从用户操作的角度检查结果。页面是否能打开只是其中一个环节;用户要求的操作流程是否能完成,更能说明产品功能有没有真正实现。举一个示意例子:如果需求包含创建和修改记录,只有一个漂亮的列表页面还不够。
重点测试:需求理解、功能覆盖、应用各部分的整合,以及端到端可用性。 浏览器评测也有自身限制,例如评估 Agent 对界面的理解会影响结果;论文专门讨论了评估器与人工判断的一致性。Vibe Code Bench 论文
Terminal-Bench:AI 能不能熟练地在终端里做事?
Terminal-Bench 给 Agent 一个终端环境,让它自主完成任务,例如编译代码、配置服务或运行训练。Agent 可以执行命令、读取输出,并根据错误继续调整操作。
它的特点是以可执行环境为中心。写出看起来正确的命令,并不等于实际执行成功;依赖、文件路径、配置和运行状态都会影响最终结果。评测需要观察 Agent 是否把环境推进到了要求的状态。
重点测试:命令行使用、环境理解、故障定位、工具组合和执行后的验证。 它覆盖的范围可以超出日常编程。该项目会修订任务与资源配置,因此 Terminal-Bench 的版本号是结果的一部分。Terminal-Bench 官方更新记录
PostTrainBench:AI 能不能训练并改进另一个语言模型?
PostTrainBench 评估 Agent 自主完成语言模型后训练的能力。后训练可以简单理解为:在基础模型已经训练出来之后,通过进一步训练,让它在目标任务上表现得更好。
在论文设定中,Agent 获得目标基础模型、单张 H100 GPU 和 10 小时预算,自行寻找信息、准备数据并执行实验。最终关注的是经过后训练的模型在指定评测上的表现。它把编写训练代码、安排实验和产出有效模型连接成了一项工作。
重点测试:训练方案设计、数据准备、机器学习工程、实验迭代和算力分配。 评价对象包含训练结果及过程约束,例如不能靠直接使用测试答案获得虚假的提升。PostTrainBench 论文
OSWorld 2.0:AI 能不能在电脑上完成复杂操作流程?
OSWorld 2.0 是计算机使用能力评测,任务覆盖日常与专业工作中的长流程操作。它要求 Agent 在软件环境中持续完成操作,而流程中可能出现动态变化、跨来源信息和不直接显示的状态。
它的特点是强调实际工作里的连续性。Agent 不仅要识别当前界面,还要记住之前的要求、理解操作结果,并在流程变化时继续推进。论文同时报告整项任务是否完成的二元指标,以及完成部分要求所获得的部分得分。
重点测试:界面理解、跨软件协作、状态追踪、约束保持和长流程执行。 如果 Agent 把图表做出来了,却忽略了指定的数据范围,部分操作可以成功,整项任务仍可能不合格。OSWorld 2.0 论文
Agents' Last Exam:AI 能不能交付一项专业工作?
Agents' Last Exam,简称 ALE,围绕具有经济价值、结果可验证的专业任务展开。它在真实操作系统沙盒中运行 Agent,让系统使用命令行和图形界面等能力,最后检查产生的文件或其他工作成果。
它的特点是把完整交付放在中心。评测允许 Agent 保留自身的执行框架、工具和记忆机制,评价任务完成后留下的产物。官方框架使用隐藏参考结果和确定性评分程序,并设置不同难度的任务集合。
重点测试:专业任务理解、多工具协作、长流程执行和成果完整性。 相较于只检查一次回答,这类评测更关注系统从接收任务到提交成果的全过程。ALE 官方仓库
GraphWalks:AI 能不能在很长的材料中沿关系推理?
GraphWalks 是长上下文、多跳图推理评测。它把图写成大量有向边,例如 A 指向 B、B 指向 C,再要求模型执行广度优先搜索(BFS)或查找父节点等操作。
它的特点是把“容纳很多文字”和“利用这些文字完成推理”区分开来。模型要正确追踪节点之间的关系,返回符合条件的节点集合。评分用到查准率、查全率和 F1,既检查有没有遗漏,也检查有没有多报。
重点测试:长上下文信息利用、多跳关系推理和集合输出的准确性。 它属于支撑 Agent 的基础能力测试;这里的 F1 不能直接当成现实工作任务的成功率。GraphWalks 官方数据集
Chartography:AI 能不能读懂专业人士使用的图表?
Chartography 是专业图表理解评测。其任务从医学、工程、金融、制造和科学等实践领域选取图表,由专业人士提出问题,并经过额外的专家核验。
它的特点是图表形式与解释规则更专业。模型可能需要读出稀疏坐标上的数值、辨认细微视觉特征、理解投影几何,或遵循特定领域的图示约定。知道相关领域的文字知识,也可能因为看错图而答错题。
重点测试:精细视觉感知、坐标与数值读取、专业图示理解和结合图像进行推理。 它有助于检查图表分析能力,尤其是普通柱状图、折线图之外的复杂视觉材料。Chartography 论文
LVBench:AI 能不能理解一段很长的视频?
LVBench 面向长视频理解与信息提取。与短片段问答相比,长视频中的关键信息可能相隔很远,模型需要在更大时间跨度内保留信息并理解内容。
它的特点是同时考验“看到了什么”和“较早之前发生过什么”。可以用一个示意问题理解其难点:视频后半段出现的行为,可能要结合前半段的信息才能解释。只分析几个孤立画面,容易丢掉上下文。
重点测试:长时间跨度的信息保留、视频内容理解与相关信息提取。 它主要检验视频理解能力;视频剪辑、文件导出等工作还需要其他执行能力。LVBench 论文
CWE-bench v1:AI 能不能发现并修复代码漏洞?
CWE-bench v1 是防御性网络安全评测,任务围绕真实代码库的审计与修补。Agent 需要检查代码、发现问题并提交修复,而任务不会预先告诉它所有漏洞的位置和数量。
它的特点是同时要求修复安全问题和保留正常功能。验证器检查攻击路径是否被阻断、原有测试是否仍然通过;v1 还提供程序化验证和评审面板的不同结果。删除受影响功能虽然可能让攻击失效,却不一定构成合格修复。
重点测试:代码安全分析、漏洞定位、补丁设计和回归保护。 CWE 是常见弱点枚举(Common Weakness Enumeration)的缩写,用来描述不同类型的软件安全弱点。CWE-bench 官方说明
理解这些评测后,可以把它们放回同一条能力链:GraphWalks、Chartography 和 LVBench 关注信息处理与感知;软件、终端和训练类评测检查专业执行;AutomationBench、OSWorld 和 ALE 进一步检查多步流程与成果交付;Vals Index 则在多个领域之上做汇总。
它们共同描绘了 AI Agent 的能力范围。看到某个 benchmark 的成绩时,先把名字翻译成具体任务:它是在修代码、构建应用、操作电脑,还是理解图表?再核对版本、工具、运行预算和评分规则,就更容易理解这个成绩究竟说明了什么。
资料核验日期:2026 年 10 月 1 日。本文介绍代表性评测与指数,并非完整目录。示意场景用于解释任务形态,不代表评测原题。各评测的任务和方法会随版本更新,具体以文中官方资料为准。
If you read this far — thank you.
Come tell me what you thought on X.